Agent Workbench:让你的编码智能体像一个团队一样干活
Agent Workbench 正式公开了。它是给 Claude Code 和 Codex 用的一组 skill 和 hook,让你对话的那个会话像组长一样工作:先做计划,把活拆开交给成本更低的 Worker,检查完结果再告诉你做完了。
一条命令安装,不需要额外的应用、服务器或面板:
npx @onsager/awb setup
代码以 MIT 协议开源在 GitHub:onsager-ai/agent-workbench。
为什么做它
一个编码智能体放着不管,会有几个又费钱又费精力的习惯。改一行代码也用最贵的模型;两小时前你批准过什么,它记不住;直接往 main 上提交;守着 CI 一遍遍轮询;结束一轮时把问题埋在状态汇报的第三段里。上下文用完,下一个会话又从零开始。
管理这一面,我在《怎么才能不给 agent 当保姆?》里写过:没人告诉它权限边界在哪、「做完」长什么样,它只能不停回头问。在 T3 Code 那篇里,我也讲过自己怎样通过几个项目经理会话,让一百多个 agent 干活。Agent Workbench 就是让那套做法跑得起来的规则,现在打包好了,你可以自己装上用。
怎么运作

你对话的会话就是 Manager(负责规划和验收的主会话)。它用的还是你选的模型。小问题和日常修改它自己处理;分量重的工作,它会拆成几块,每块写一份任务说明,交给 Worker(执行任务的子会话)。Worker 就是 harness 自带的 subagent,权限和沙箱跟着 harness 走,互不依赖的部分可以并行跑。
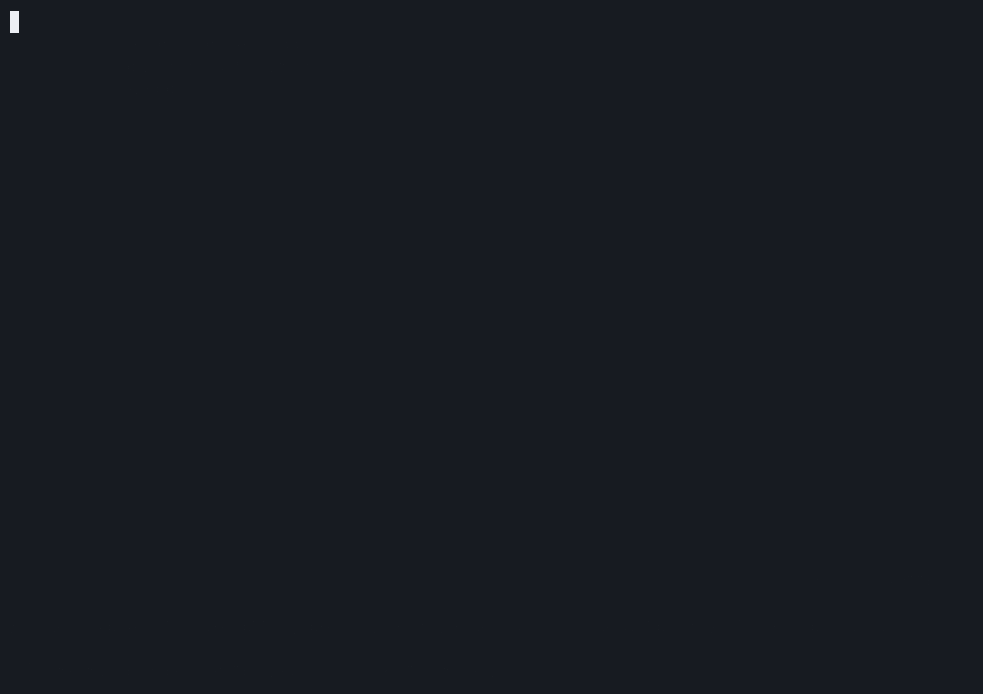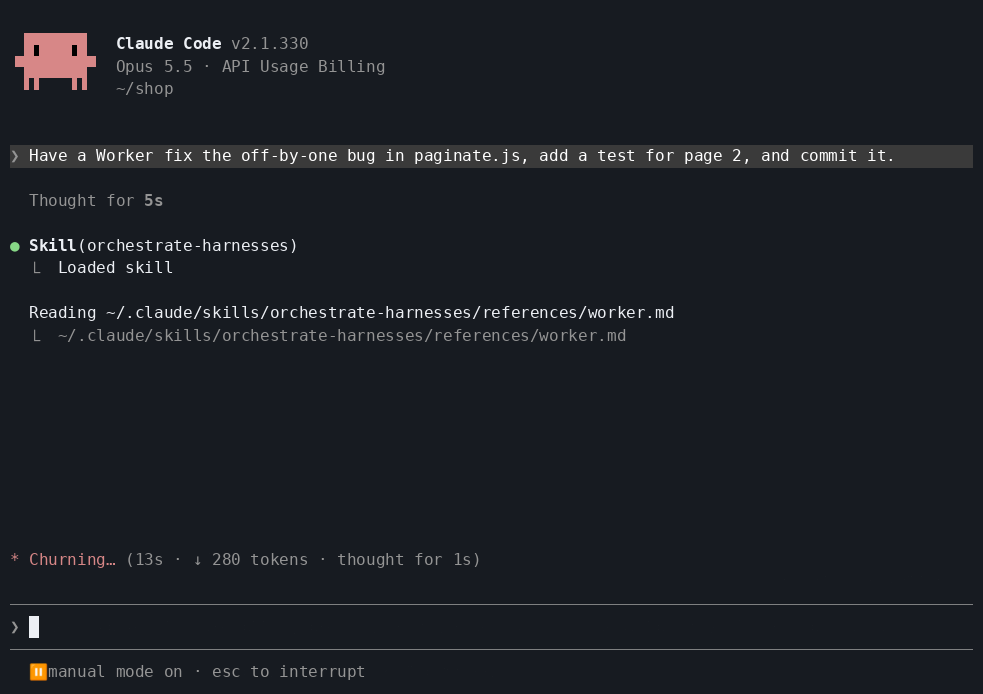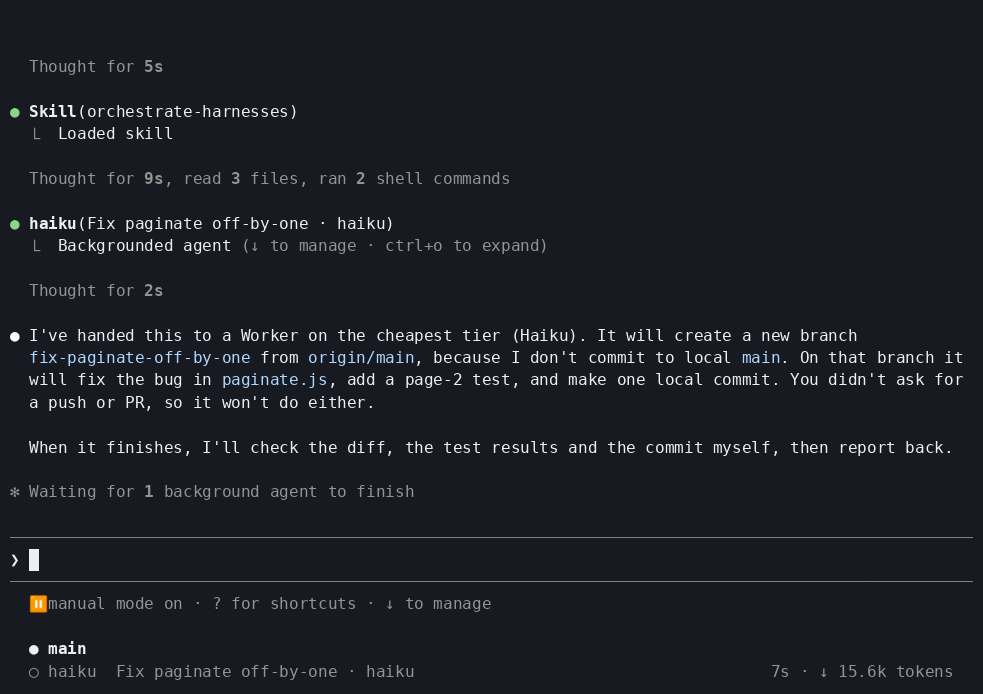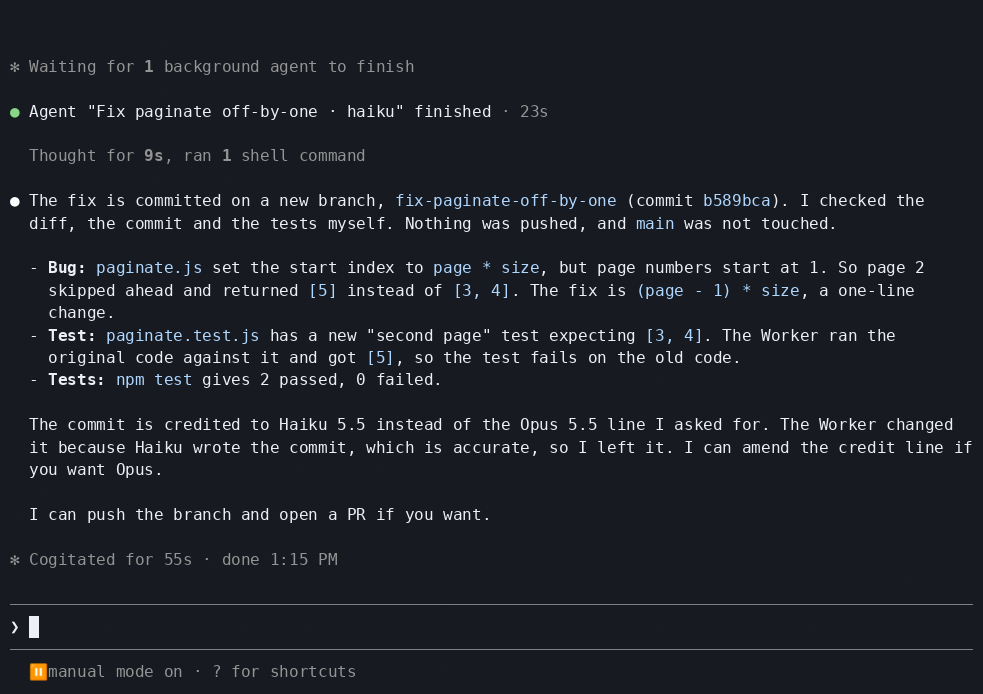
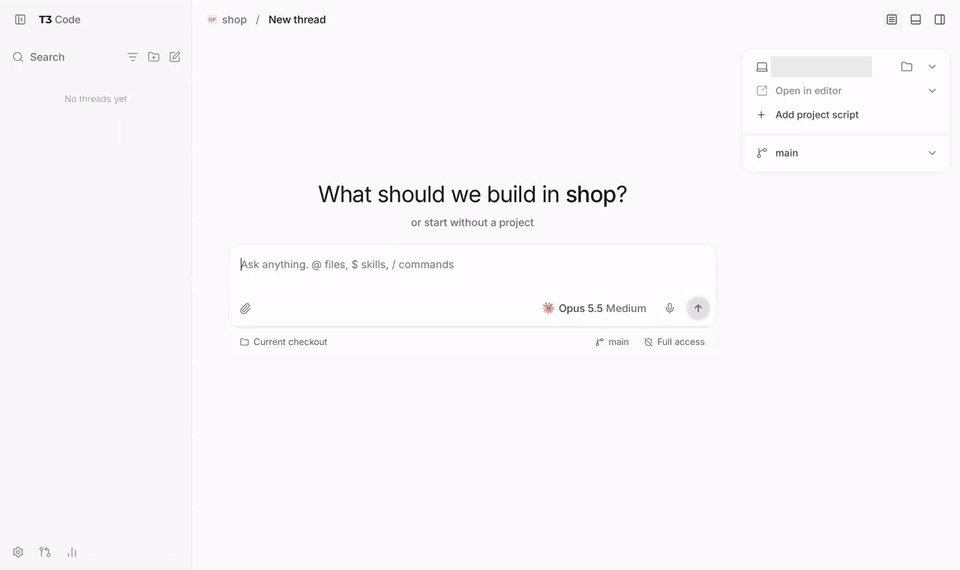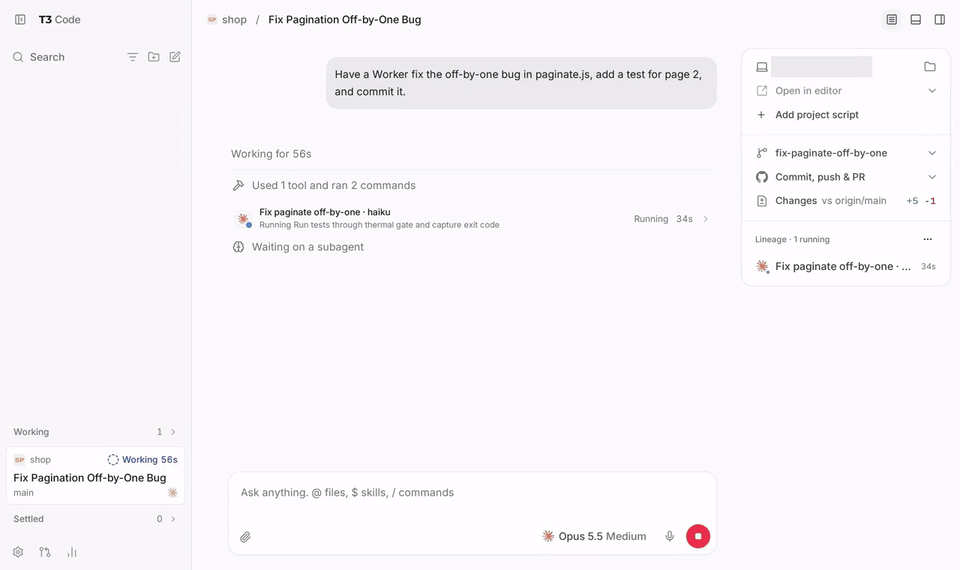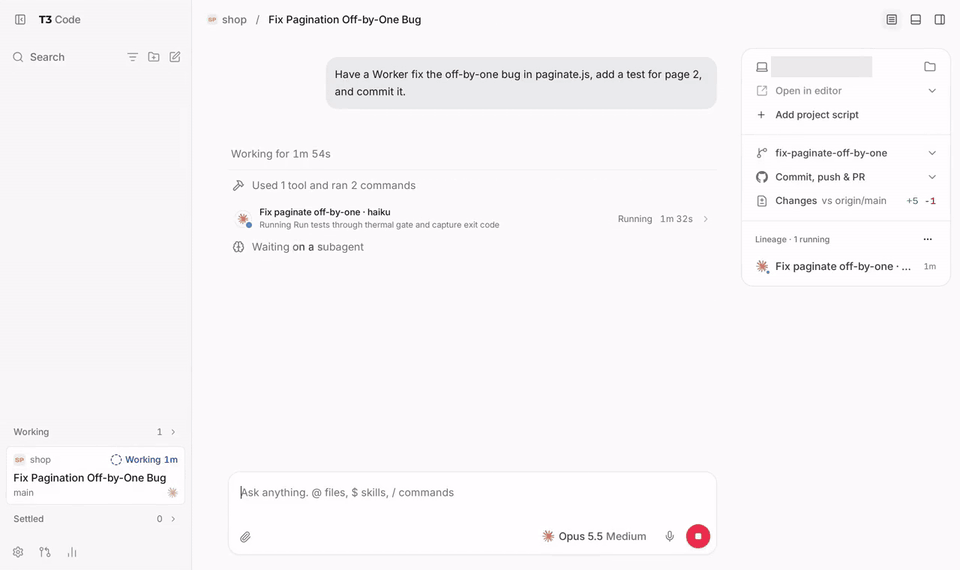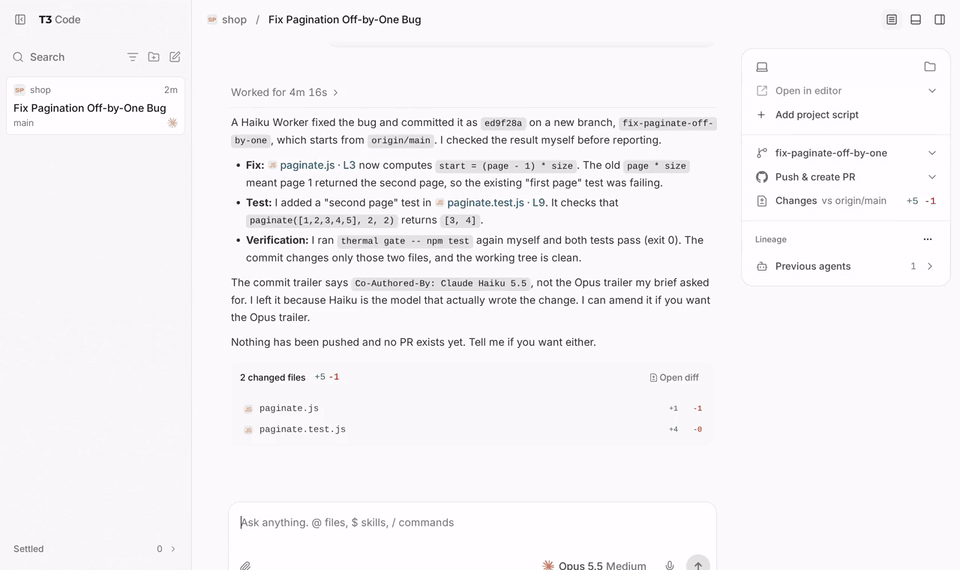
Manager 先检查,再汇报。 它看的是真实的分支、提交和 CI 结果,而不只是 Worker 交上来的总结。返工两轮还不行,它会回来找你,不会再试第三次。
下面是装好之后一个真实的 Claude Code 会话。Manager 把一个 off-by-one 修复交给 Worker,然后自己检查 diff、提交和测试,才向你汇报:
能得到什么
Worker 分级
Worker 从三个级别里选:
| 级别 | 模型 | 适合做什么 |
|---|---|---|
| L1 | 快速、低成本的模型 | 范围明确的任务 |
| L2 | 能力更强的通用模型 | 研究、技术试验、架构 |
| L3 | 能力最强的模型 | 每项任务都要你先批准 |
Manager 按任务类型从最低的合适级别开始。往上升级要写明理由,用 L3 每次都要你点头。
每个级别对应什么模型,由你决定。对应关系都写在 workers.yml 一个文件里,任何模型都能放到任何级别:Claude、Codex,或者 Magpie、cc-switch 这类网关转发的模型都行。经常切换服务商的话,可以启用一套用通用名字(fast、standard、expert)的配置,这样配置里就不会写死某家的模型名。
用 hook 守住规则
光写在说明里的规则会慢慢走样。最要紧的几条由一个策略 hook 兜底,它在派发 subagent、执行 shell 命令和结束一轮时都会检查:
- 不在本地
main上提交。 切换到本地main或master、在上面提交或推送都会被拦下,每个改动都从任务分支开始。 - 用贵的 Worker 之前先问。 派发 L3 Worker 会停下来等你批准。
- 不轮询 CI。
gh pr checks --watch、围绕gh的sleep循环这类命令会被拦下,智能体改为等 harness 自己的通知。 - 问题点一下就能答。 如果智能体在正文里提问就结束这一轮,会被打回去,改用提问工具,推荐选项放在最前面。
交接不会丢
Manager 会记下你要什么、批准过什么、哪个任务归谁。之后换一个会话,甚至换一台机器,都能照着交接记录接着做,不用重复操作,也不用再问你一遍。配合 T3 Code,不同对话、不同 harness、不同机器上的 Manager 可以通过 T3 的对话互相协调:
主机运维
一台机器上跑很多 agent 时,还有两个附加功能。awb ops thermal 是可选的 CPU 温度闸门,用在装有受支持传感器的 Linux 机器上:机器太热时先压住高负载的本地任务,等降温再跑。host-ops 这个 skill 则给智能体定了规矩:高 CPU 负载的任务怎么跑,磁盘空间怎么查、怎么清。
和同类工具比
这个领域的工具大多在做三件事之一:让很多 agent 并排跑,提供一大套提示词,或者教一种开发方法。Agent Workbench 这三件都不做。只用一个 Manager 带几个 Worker,是有意这么设计的:我在《为什么 AI Agent 团队也逃不过“人多了反而慢”?》里看过一些研究,一步接一步的任务,agent 加得越多往往越差,因为协调成本涨得比产出快。它是 Claude Code 和 Codex 自带 subagent 之上很薄的一层规则,补上它们留给你自己操心的部分:用哪个模型,什么时候问你,什么要拦,任务怎么交接。它可以和 Conductor、Claude Squad 这类并行会话应用一起用,那些工具管的是终端和 worktree,不管模型选择和审批。
如果你想要 TDD 那样一步步走的方法,可以看 Superpowers;想要现成的专项 agent,可以用 wshobson/agents 这样的合集;只用 Cursor 或 Gemini CLI 的话,它目前也不支持。完整的对比表见概览文档。
开始使用
-
安装 skill、Worker subagent 和策略 hook:
npx @onsager/awb setup -
如果你用 Codex,先检查并信任它的 hook:
awb trust -
在 Claude Code 或 Codex 里开一个新会话,它就是你的 Manager 了。给它一个真实的任务,看看它会怎么分派。
设置只写入你的主目录,不会碰你的代码仓库。你自己的说明和 hook 都会保留,awb uninstall 能恢复到安装前的样子。设置不会帮你安装 Claude Code 或 Codex,也不会帮你登录,你得先有至少一个能正常用。
仓库地址是 github.com/onsager-ai/agent-workbench,有中文 README。这是第一个公开版本,现在提 issue 和 PR 最有用:Manager 哪里分派得不好,哪个 hook 碍了你的事,下一个想支持哪个 harness,都欢迎告诉我。